
请用你的家乡话来说一下下面这段内容
“这个项目也得到了日本政府的支持。”
“七纵接到命令后,立刻从集结地区郑家屯出发。”
大家看到这样的问题会不会觉得有问题?
觉得有问题就对了。
最近在网上,有一款叫“方言搜集”的小程序,在网上火了。只不过火的原因,开头和结尾不太一样。
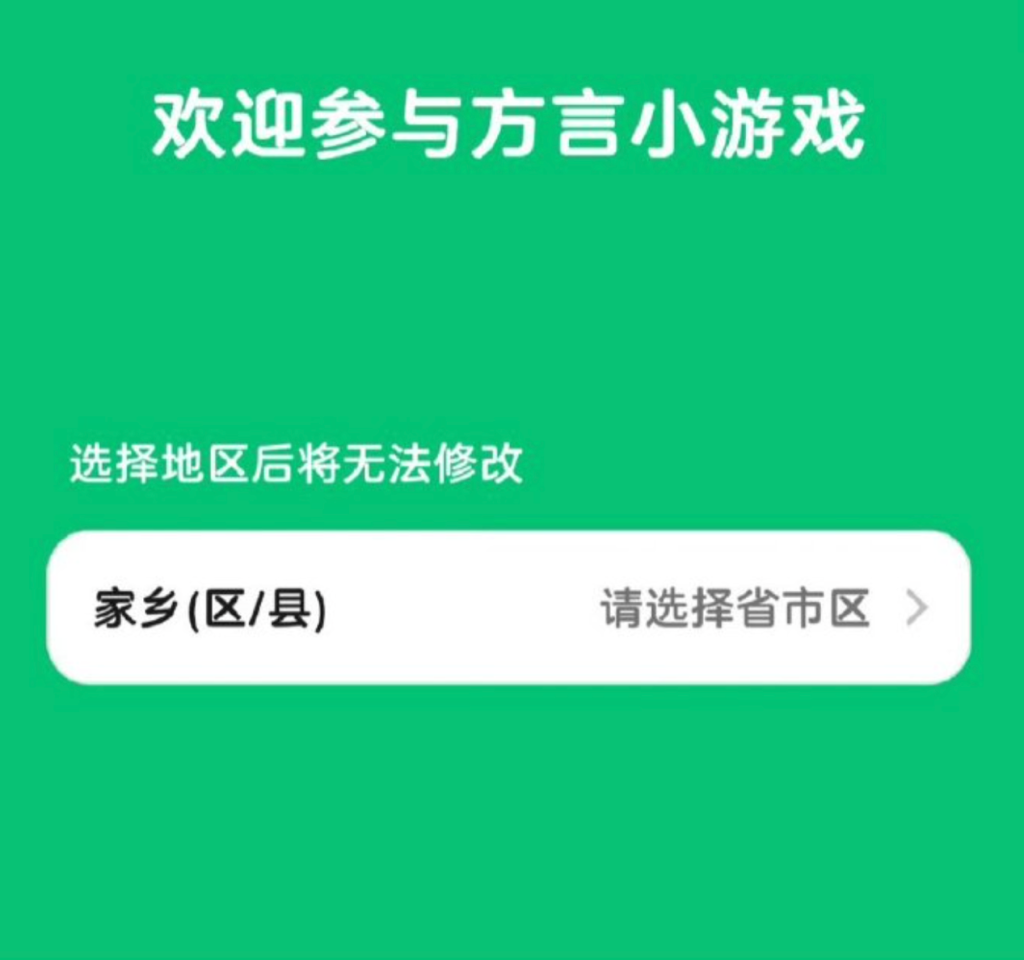
最开始,这款小程序火,主要是因为它做了个付费采集的项目,无论是谁,打开绿色软件小程序,念几句自己家乡的方言,就有钱拿。这种活动,就跟超市门口发的鸡蛋、拼夕夕的砍一刀一样,总是不缺人参加的。别说大家了,就是乌鸦自己,当年也在家庭群里转发过“帮我砍一刀”。
但很快,免费的鸡蛋领着领着,大家就发现不对了。这个程序最初的宣传,是让人用方言念一些句子,搜集语料,用来帮助扩充方言语音识别的训练库,方便以后”文字转译”。但是如果真的上手做任务,就会发现两个特别奇怪的地方。
首先,是这个小程序里要求的方言粒度太细了,细得离谱。
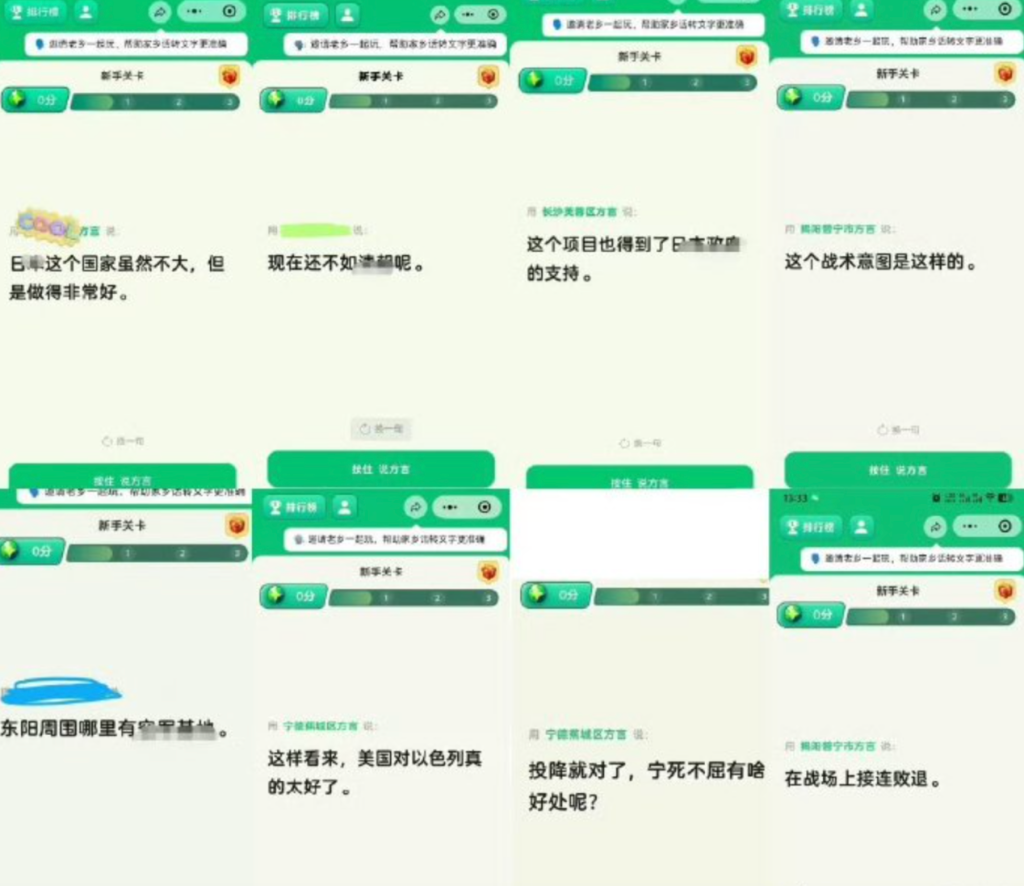
一般大家讲方言,基本精确到省,最多也就是到市一级。但这个小程序里搜集的语料,不是”湖南话””河南话”,甚至不是”长沙话””新乡话”,而是直接具体到区县一级,指明要搜集记录”新乡延津县方言””长沙芙蓉区方言”,这就让人有点毛骨悚然。
如果单纯是服务于方言转译,按常理来说不至于精细到这一步,一个省一个模型,顶多一个市一个模型,完全够用了。你精确到县,精确到区,转译准确率可能至多也就零点几个百分点,但付出的训练成本可是几何倍数地往上翻,从公司训练成本出发性价比极低。一般服务于商业目标的小程序,不会算不明白这笔账。
其次,就是这个小程序随机生成的一批例句,非常邪门。总结一下网友上传的截图,这批号称是随机生成的例句里包括但不限于:”这个项目也得到了日本政府的支持。””七纵接到命令后,立刻从集结地区郑家屯出发。”,等等。
 付费会员
1、本文只代表作者个人观点,不代表星火智库立场,仅供大家学习参考; 2、如若转载,请注明出处:https://www.xinghuozhiku.com/554504.html

